LSTM hand position prediction
VR 장비나 힘 피드백 장치가 손을 가리면 카메라 기반 손 추적이 끊길 수 있다. 손이 시야 밖에 있는 동안에도 움직임을 이어서 추정하려면 다른 센서의 정보가 필요하다. 게임공학 수업에서는 IMU 가속도 기록으로 다음 시점의 한 축 손 이동량을 예측하는 LSTM 모델을 다뤘다.
2024년 11월에 진행한 개인 과제다. SAF 연구에서 수집한 데이터와 수업에서 제공한 PyTorch·Jupyter Notebook 베이스라인을 사용했다. 나는 LSTM 뒤의 회귀 모델과 학습 절차를 바꾸고 같은 데이터에서 기존 모델과 예측 결과를 비교했다.
입력 시퀀스와 예측 대상
제공된 데이터는 여러 참여자와 세션에서 기록한 시계열 CSV로 구성돼 있다. 각 행에는 가속도와 자이로스코프, 직전 시점과의 위치 차이, 실제 위치가 들어 있다. 이 가운데 가속도 24개 특징을 입력으로 삼았다. 연속된 다섯 시점을 하나의 입력으로 묶고 바로 다음 행의 위치 차이를 예측했다.
베이스라인은 2계층 LSTM의 출력에 선형 계층 세 개를 연결한 구조였다. 은닉 크기를 100에서 128로 늘리고 선형 계층마다 Tanh, Batch Normalization, 0.2 Dropout을 적용했다. 출력 계층 앞에는 선형 계층을 하나 더 두었다. 단순히 학습 횟수만 늘리기보다 중간 출력의 범위를 조절하고 과적합을 줄이는 쪽으로 구조를 바꿨다.
학습 절차와 종료 조건
배치 크기는 161에서 64로 줄이고 optimizer는 Adam에서 AdamW로 바꿨다. 손 위치처럼 연속된 값을 예측할 때 큰 오차 몇 개가 학습을 지나치게 끌고 가지 않도록 MSELoss 대신 SmoothL1Loss를 사용했다.
처음부터 정해진 학습률로 50 epoch만 돌리던 방식도 바꿨다. 시작 학습률을 0.0005에서 0.001로 올리고, 학습 손실이 정체되면 ReduceLROnPlateau가 학습률을 절반으로 낮추도록 했다. 최대 500 epoch를 허용하되 다섯 epoch마다 검증했다. 가장 낮은 검증값을 갱신하지 못한 검증이 10번 이어지면 중단했다. 실제 학습은 411 epoch에서 멈췄다.
동일 데이터 분할 기준 비교
free1/4_rear.csv, free2/2_rear.csv, free9/8.csv 세 기록에 기존 모델과 수정한 모델을 각각 적용했다. 같은 데이터 분할에서 비교했을 때 세 기록 모두 수정한 모델의 평균 RMSE가 더 낮았다.
아래 결과는 새로운 참여자나 세션에 대한 일반화 성능을 평가한 것은 아니다.
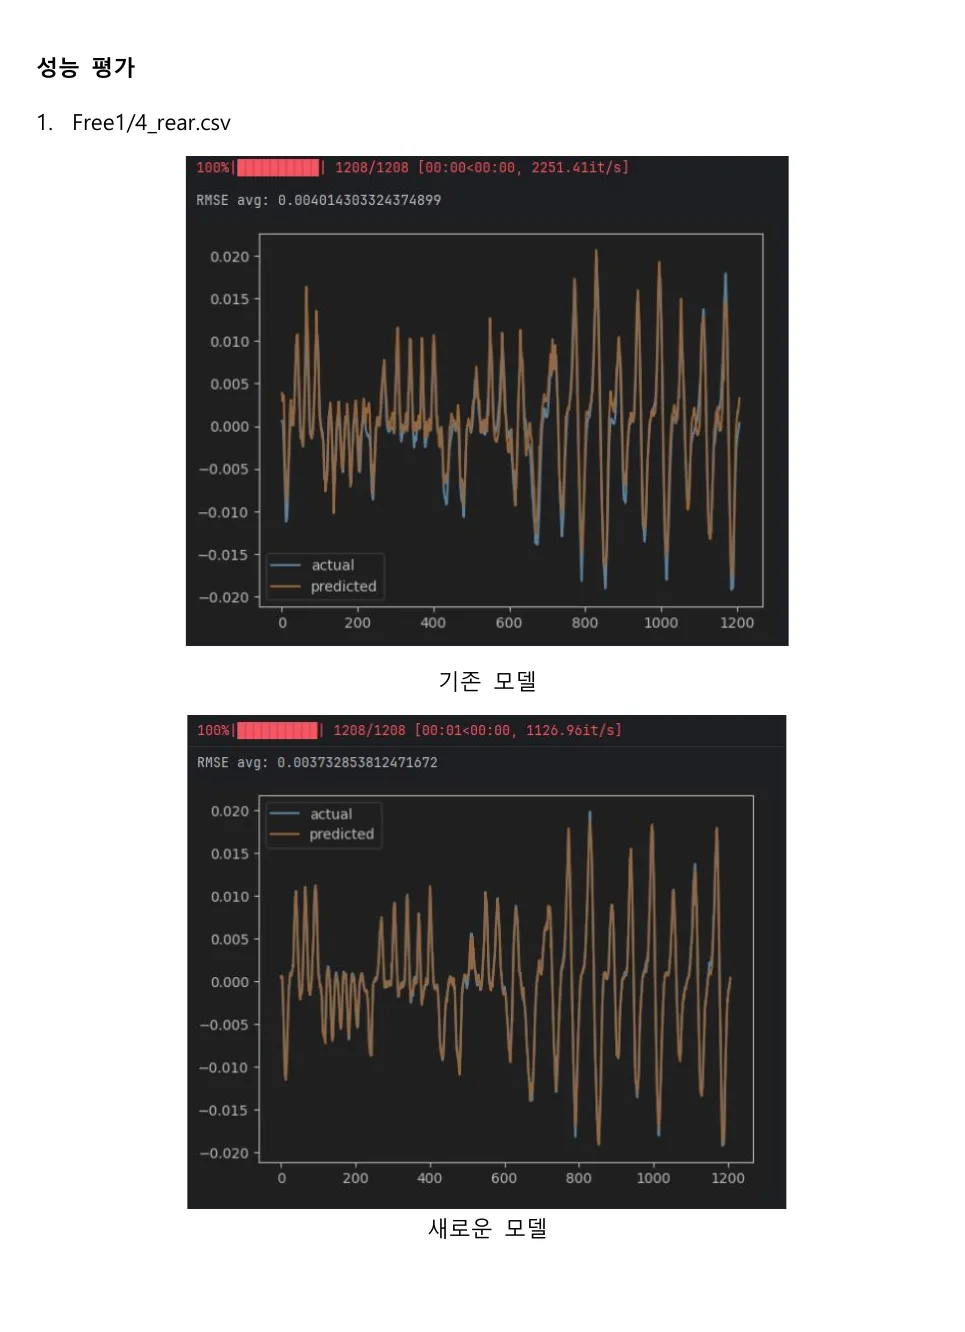
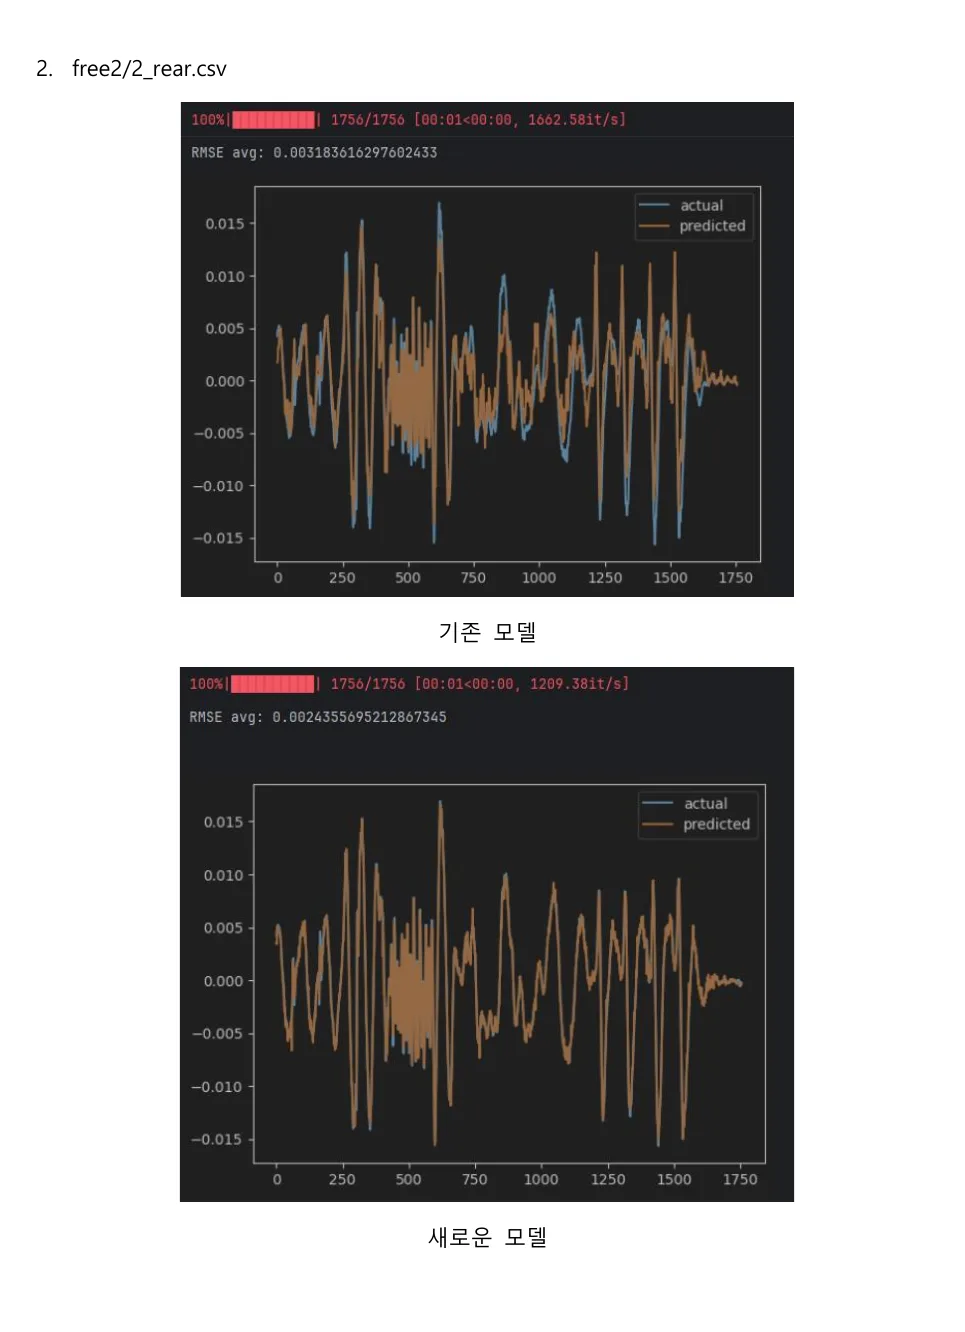
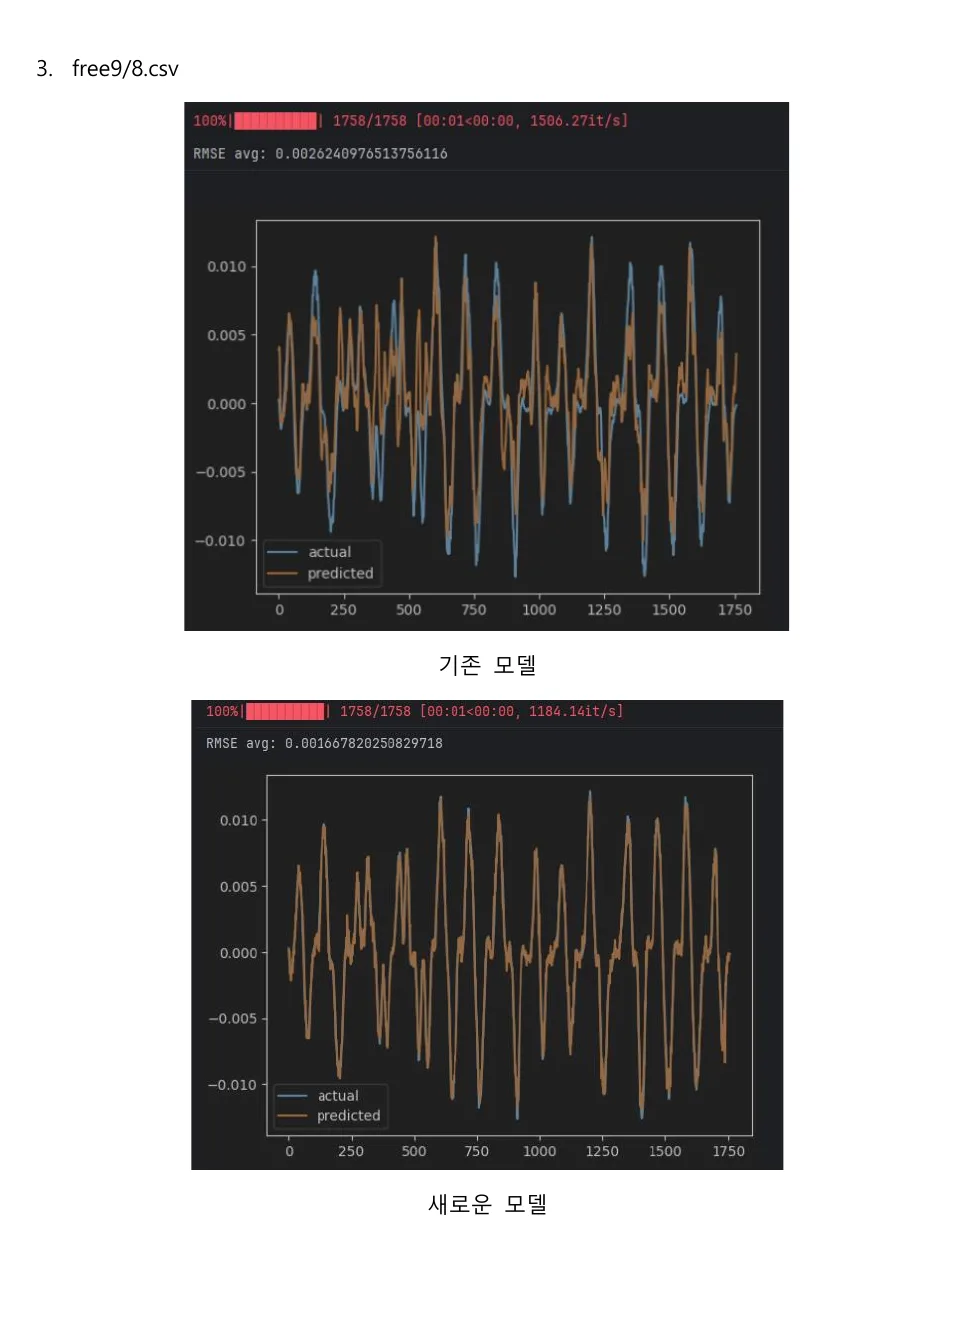
모든 CSV에서 만든 시퀀스를 한데 모아 무작위로 학습·검증 세트로 나눴고, 결과 시각화에도 이 데이터에 포함된 일부 기록을 다시 사용했다. 따라서 수치는 일반화 성능보다는 같은 데이터 분포 안에서 두 모델의 예측을 비교한 결과로 해석해야 한다.
평가 방식의 한계
검증 코드에서는 SmoothL1Loss의 제곱근을 RMSE라는 이름으로 출력하고 있었다. 파일별 평가에서는 별도로 RMSE를 계산했지만, 학습 중 기록한 검증값은 표준 RMSE가 아니다. 시퀀스도 stride 1로 겹치게 만든 뒤 무작위로 나눠 인접한 기록이 학습과 검증 양쪽에 들어갈 수 있다.
다시 실험한다면 참여자나 세션 단위로 데이터를 분리하고 학습 과정과 최종 평가에서 같은 RMSE 구현을 사용할 것이다. 완전히 분리한 테스트 세트에서 여러 번 학습해 평균과 분산까지 확인해야 모델 구조를 바꾼 효과를 제대로 판단할 수 있다.